Kafka 介绍
Kafka 介绍
Kafka 是一个分布式流处理平台,最初由 LinkedIn 开发,后来成为 Apache Software Foundation 的顶级项目。它被设计用于处理大量实时数据流,具有高吞吐量、可扩展性和容错性。
- 线程和进程间交互的问题:
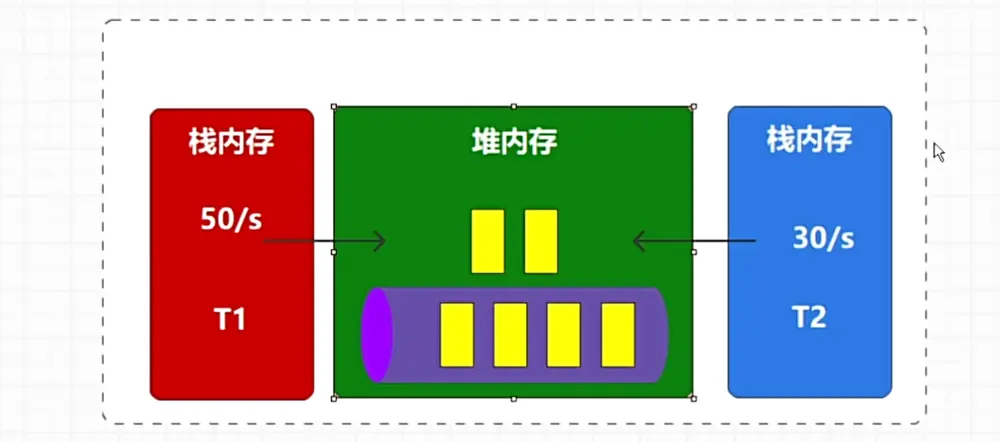
- 线程间通信的问题:
- 线程之间的通信需要共享内存或者使用消息队列等方式,这可能导致复杂的同步问题和性能瓶颈。
- 线程之间的通信可能会引入延迟,尤其是在高负载情况下,可能会影响系统的响应时间。
- 线程之间的通信需要处理并发访问和数据一致性的问题,这可能会增加开发和维护的复杂性。
- kafka消息中间件
- kafka是一个消息中间件,它提供了一个分布式的消息队列,用于存储和转发消息。
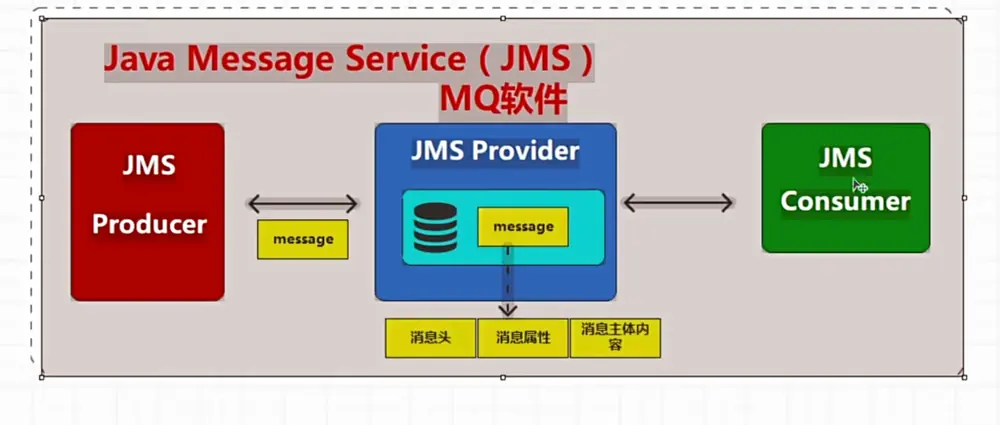
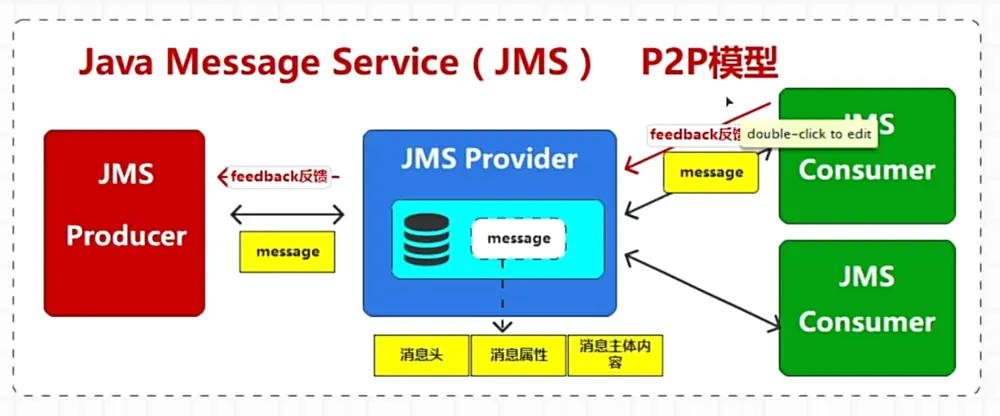
- P2P模式:
- PS模式:
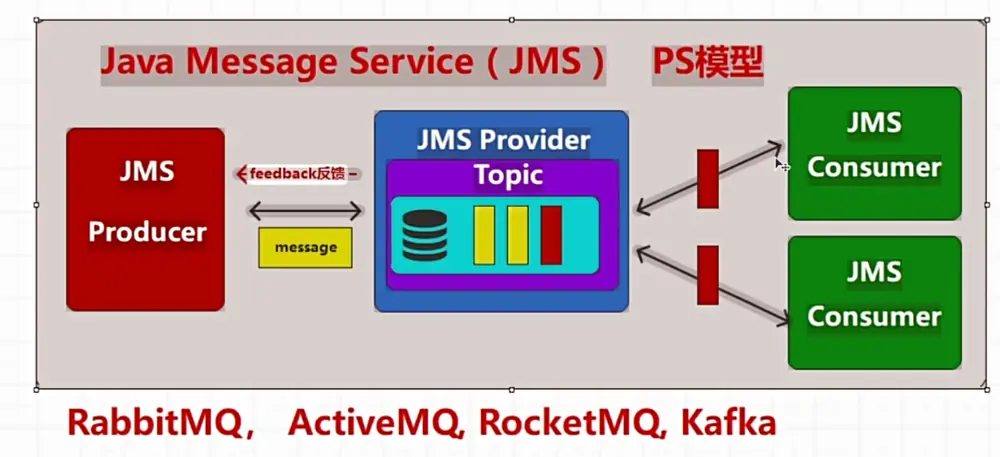
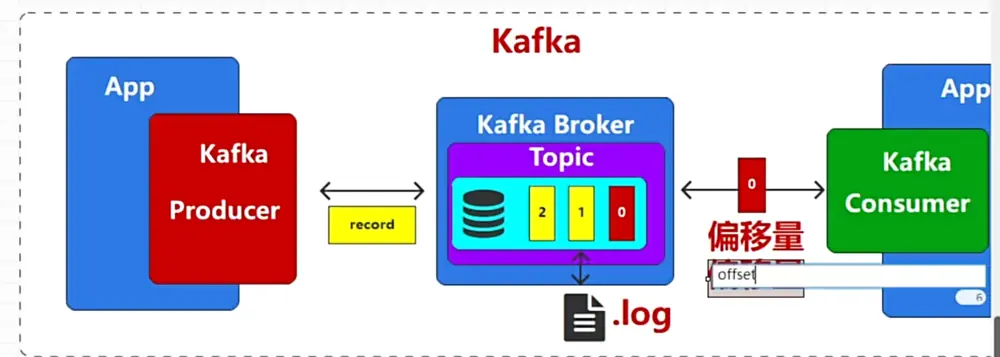
broker:kafka集群中的一个节点,负责存储和转发消息。
topic:kafka集群中的一个消息队列,用于存储和转发消息。
partition:topic中的一个逻辑分区,用于并行处理消息。
offset:消息在partition中的唯一标识符,用于定位消息的位置。
1. kafka 架构
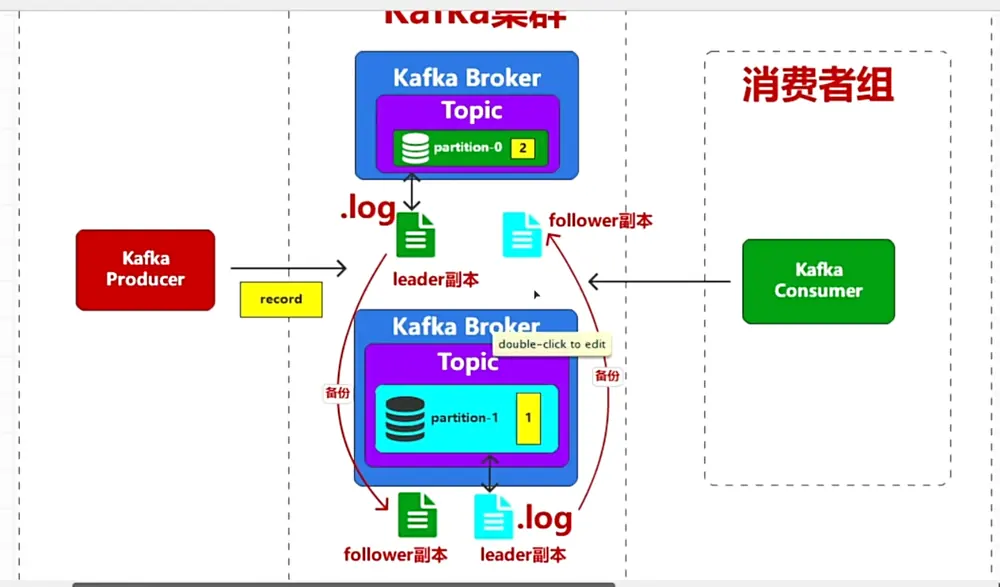
- kafka将数据文件创建副本,每个副本存储在不同的broker中,以实现高可用性。同时只有leader副本可以接收读和写入,其他副本只能接收读取。leader副本会自动选择一个follower副本作为新的leader副本,以实现高可用性。
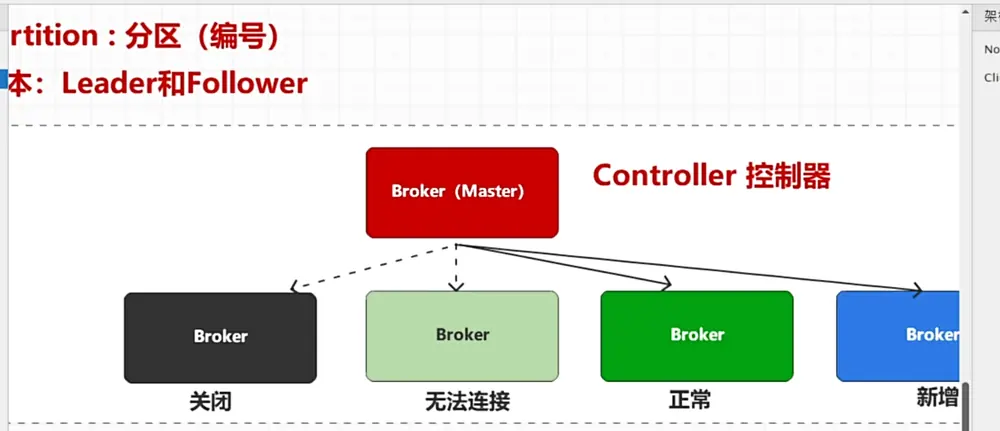
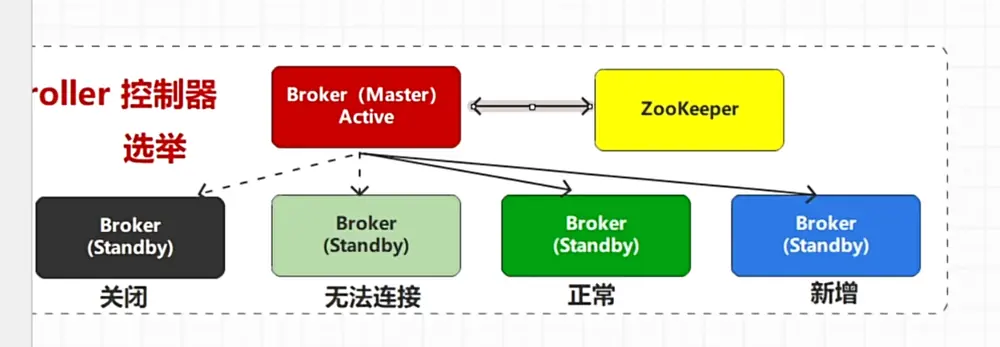
- Zookeeper:kafka集群中的一个协调服务,用于管理集群的配置信息和状态信息。 当kafka集群中发生节点故障时,Zookeeper会自动重新分配leader副本和follower副本,以实现高可用性。
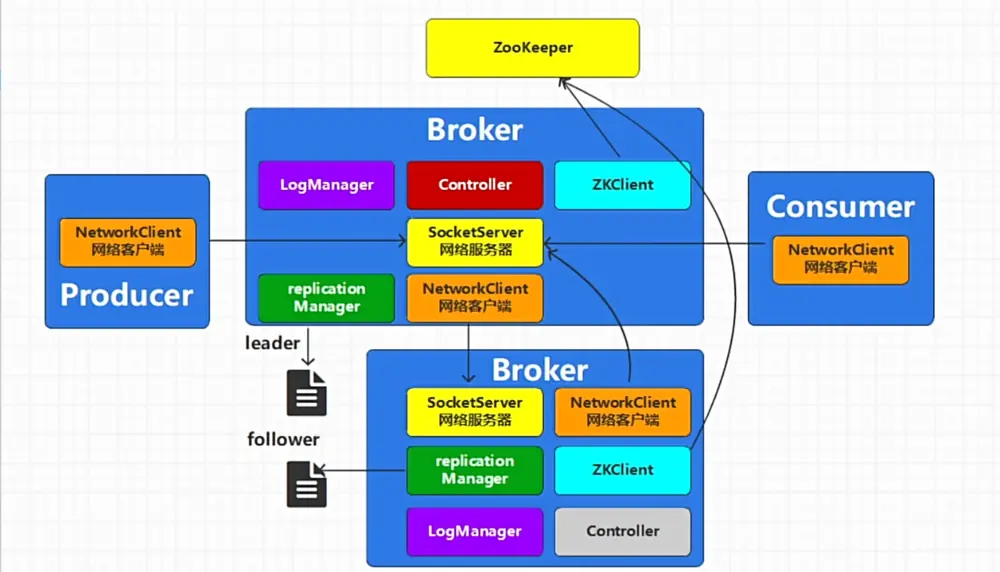
- kafka与zookeeper的关系:
- kafka依赖zookeeper来管理集群的配置信息和状态信息。
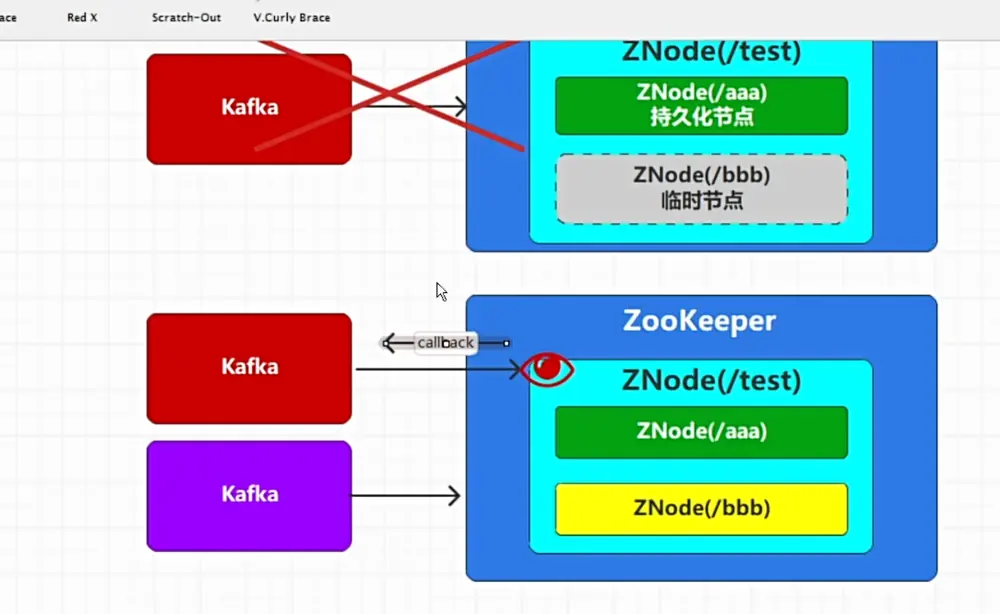
- kafka 使用ZNode (zookeeper节点节点)来存储集群的配置信息和状态信息。 ZNode本质上是一个文件系统,每个ZNode都有一个唯一的路径,路径中包含节点的名称和父节点的名称。 同时ZNode可以存储数据,也可以存储子节点。同时区分持久节点和临时节点。
2. Zookeeper
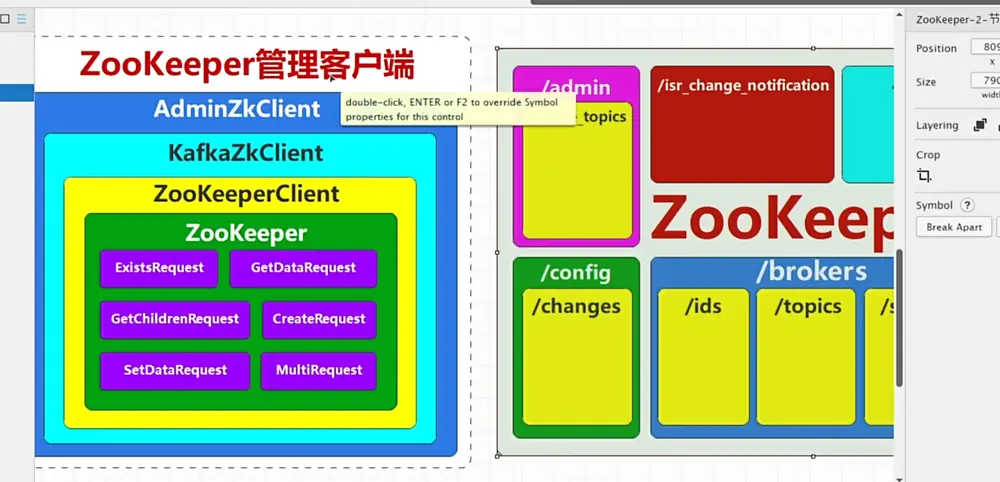
- prettyZoo : 一个用于可视化zookeeper集群的工具,它可以帮助用户理解zookeeper集群的结构和运行状态。
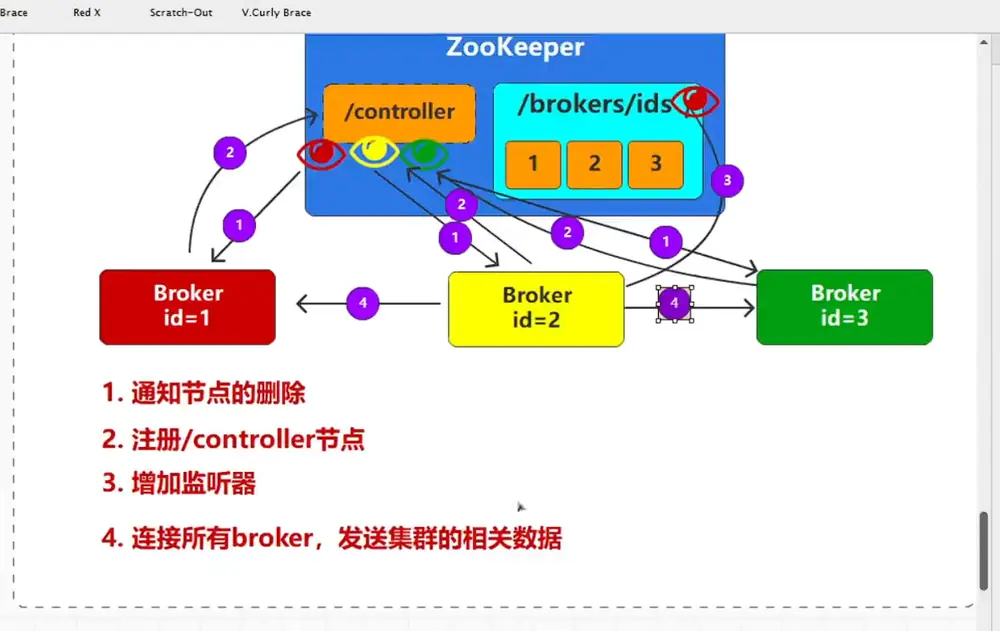
- Zookeeper 选取leader(controller)节点原理
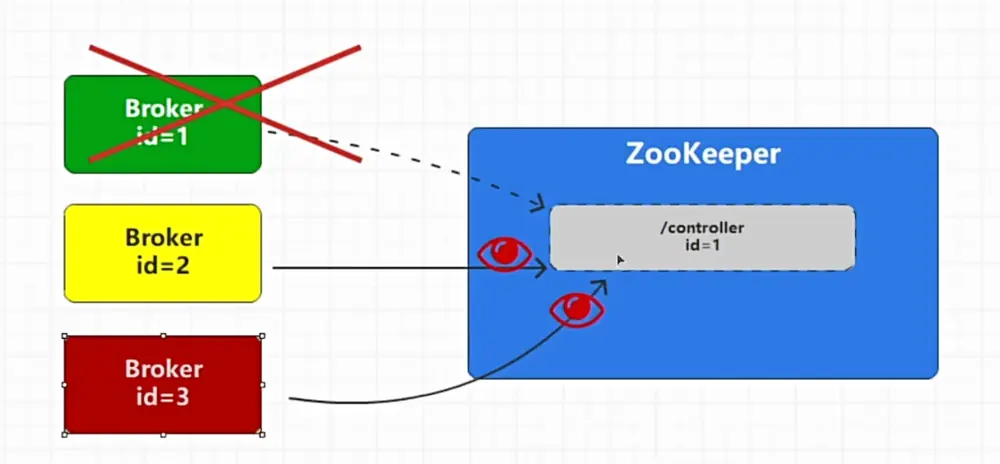
- kafka集群节点加入时,会向zookeeper注册一个节点,节点的路径为/kafka/brokers/ids/节点id,节点的值为节点的id。
- 第一个加入的节点会被选为leader节点。
- 后续加入的节点会被选为follower节点。但是会监听leader节点的事件,当leader节点发生故障时,会发起选举,选择一个follower节点作为新的leader节点。
- kafka broker 创建与Zookeeper通信注册流程
-
- 第一个broker节点加入
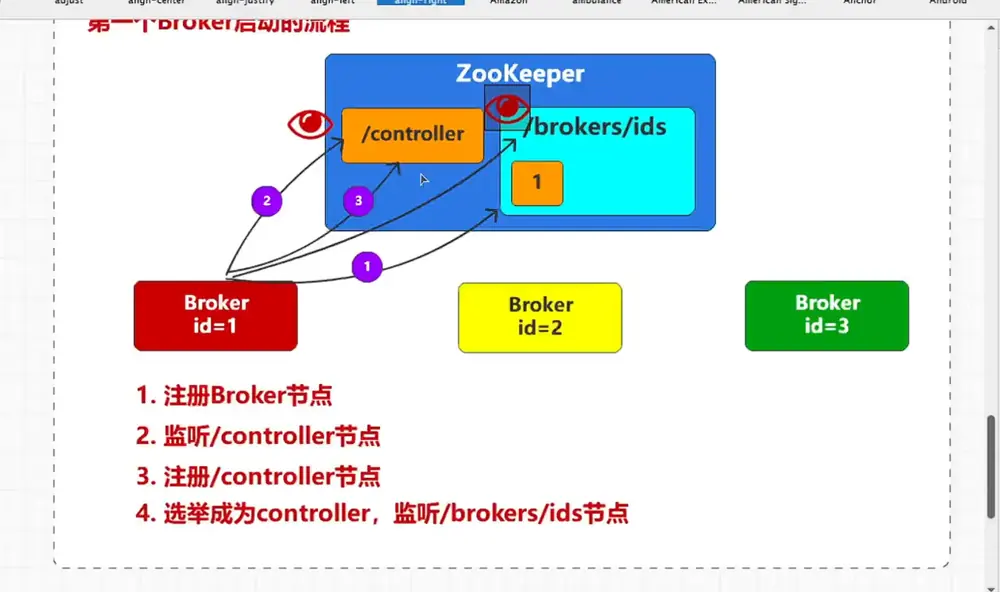
- 第一个broker节点加入
-
- 第二个broker节点加入
-
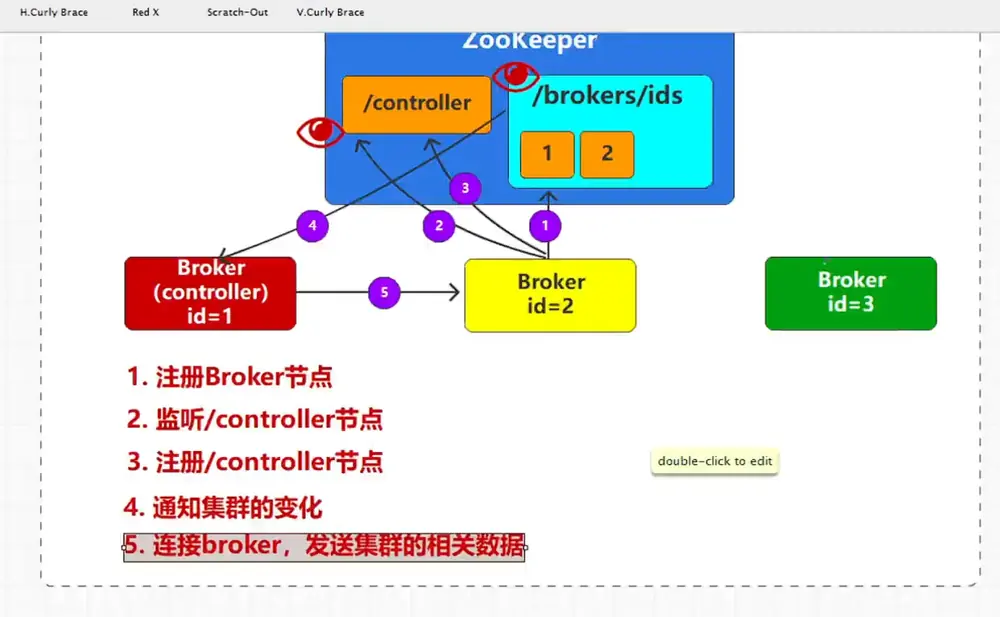
-
- 第三个broker节点加入
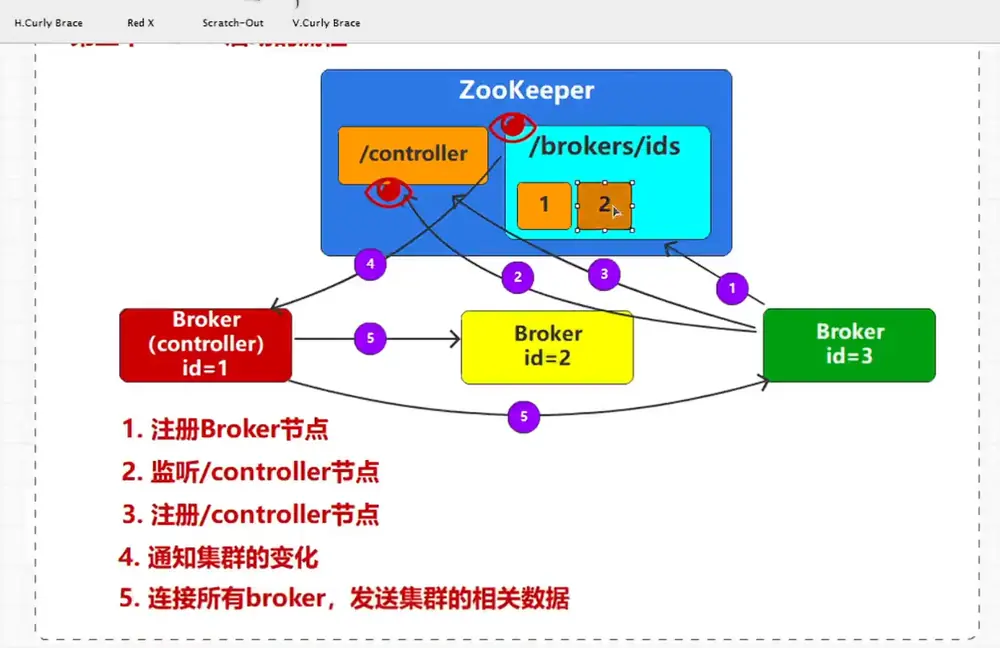
- broker 节点故障处理 流程
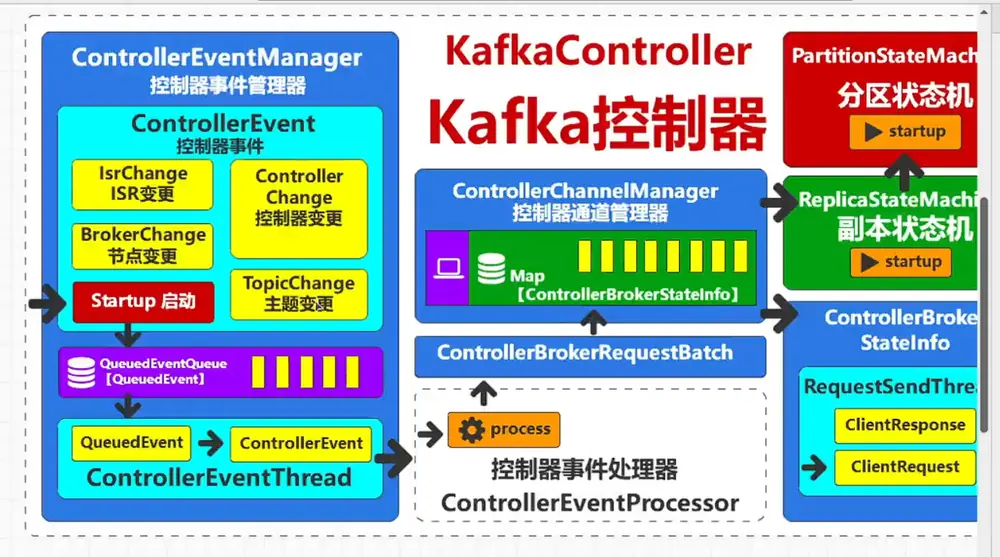
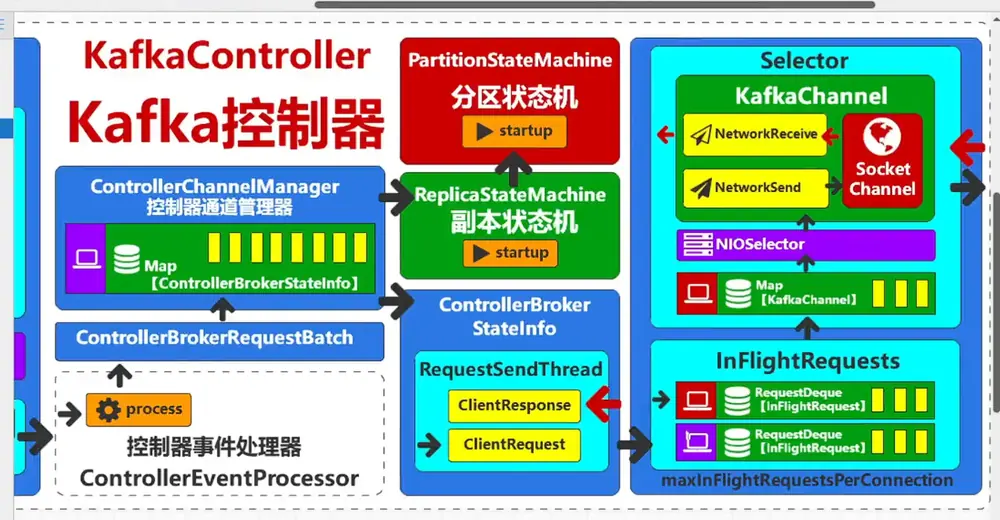
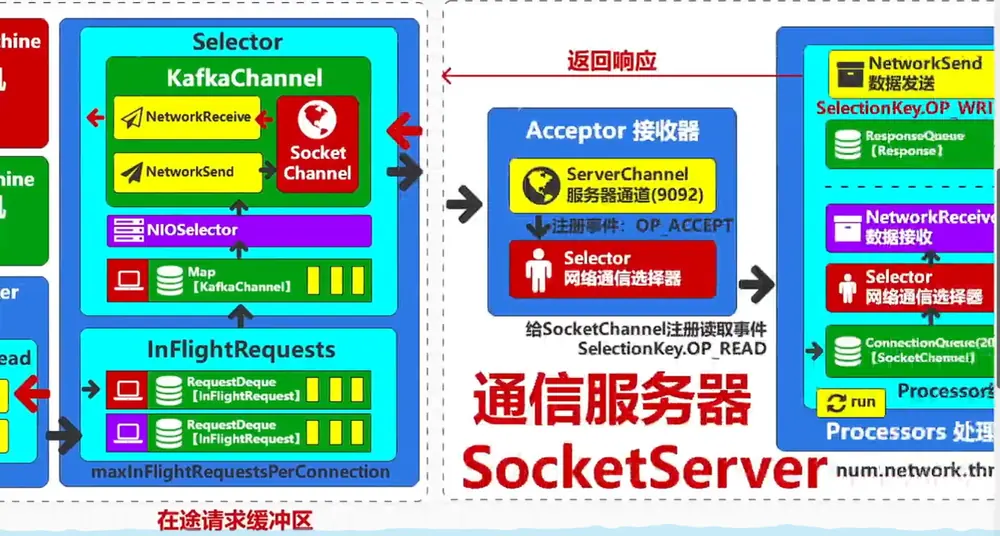
- kafka 启动工作流程
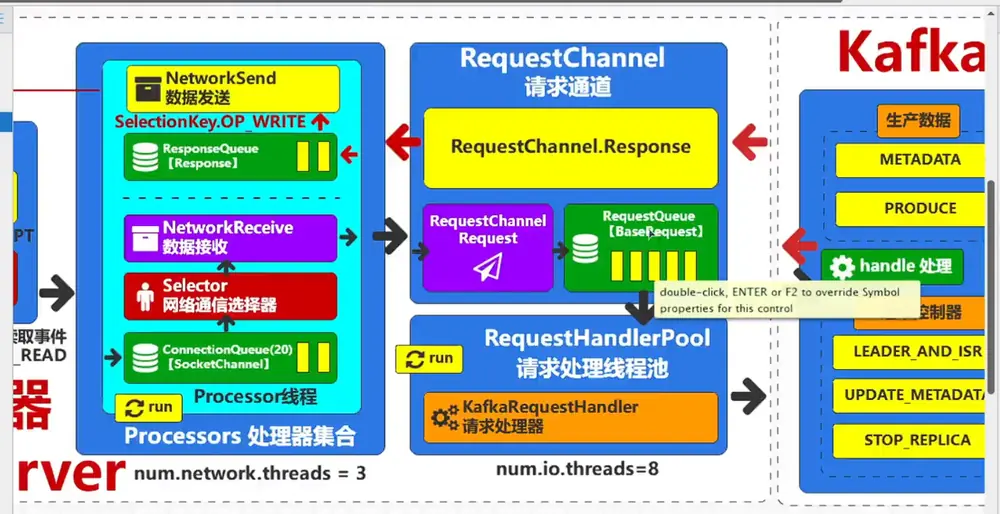
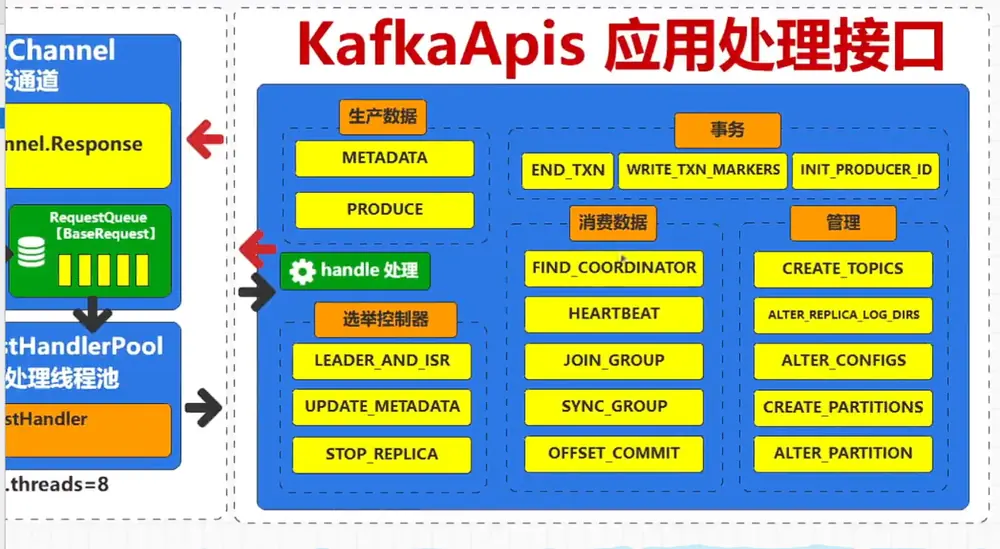
3. 主题创建
1. topic 创建
-
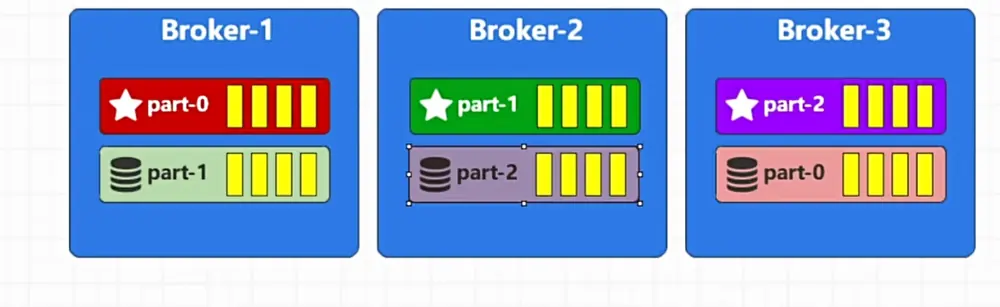
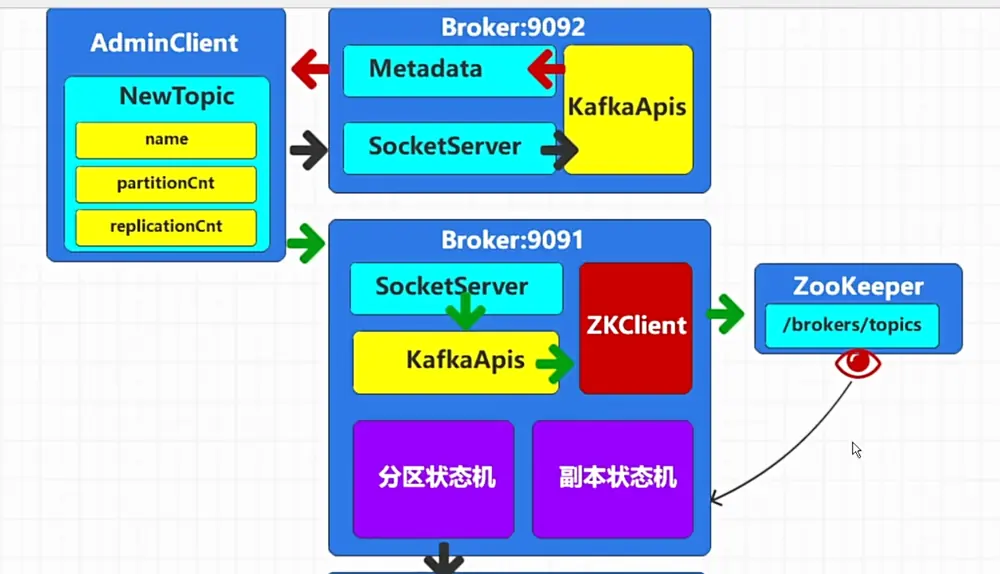
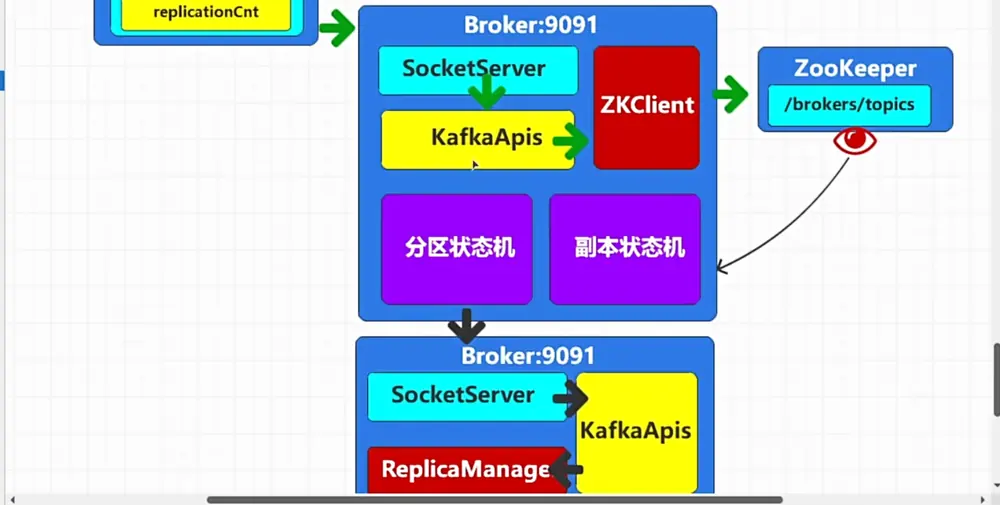
topic 一般由管理员决定其设置情况 单topic 创建
 多topic 创建
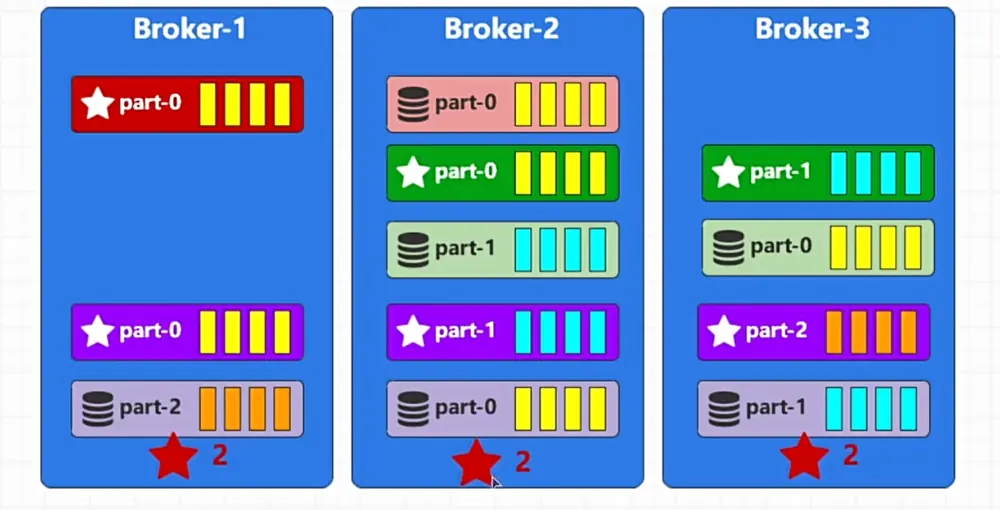
- topic分区副本设置内部有算法会进行自动分配,但是不能做到每个broker的副本数量相等。
- 可以通过初始化设置副本数量以及副本所在broker来实现副本数量的均衡。
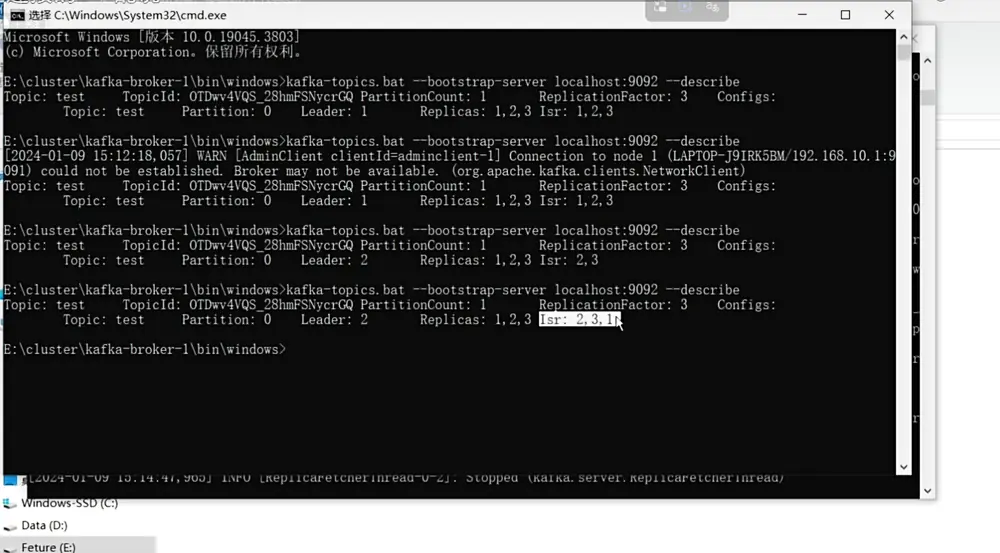
- ISR:in sync replica,同步副本,是指leader副本和follower副本之间保持一致的副本。
4. 生产数据
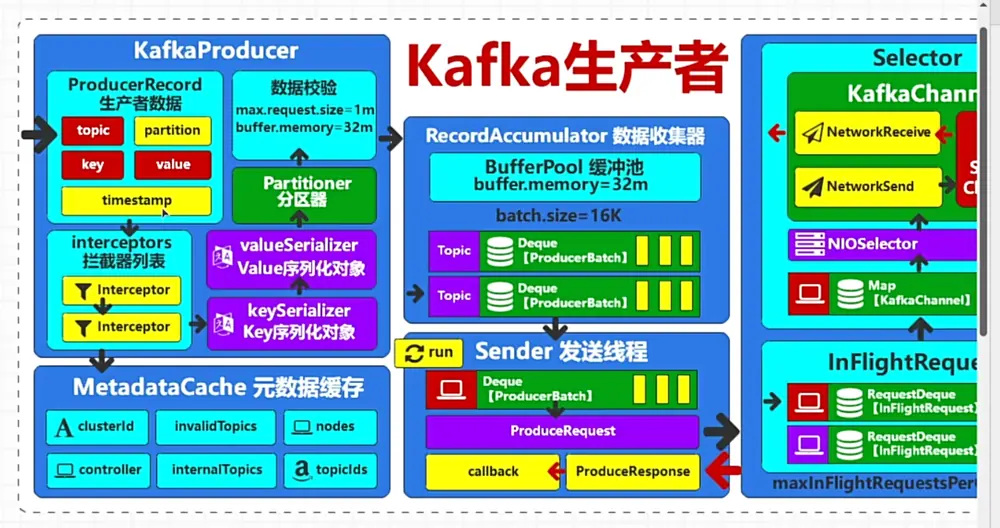
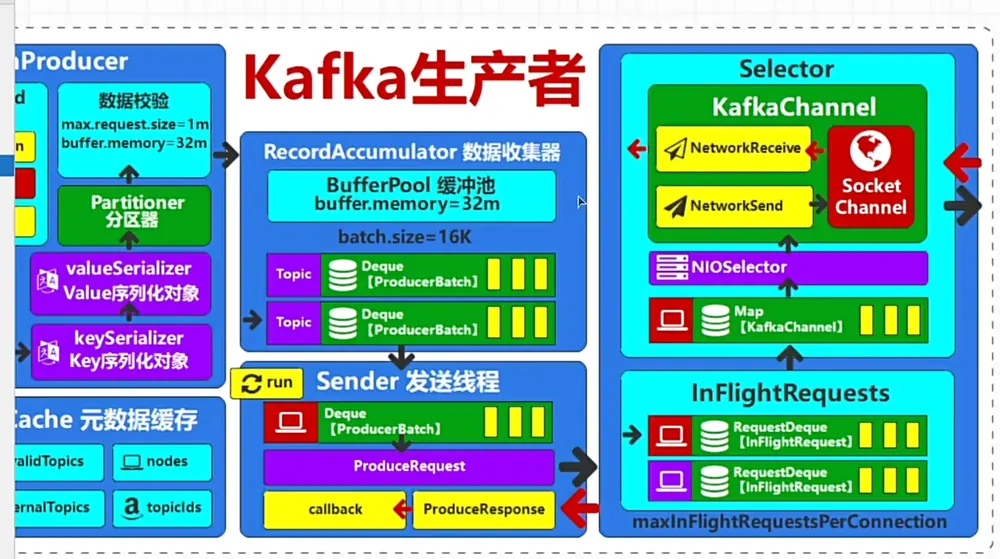
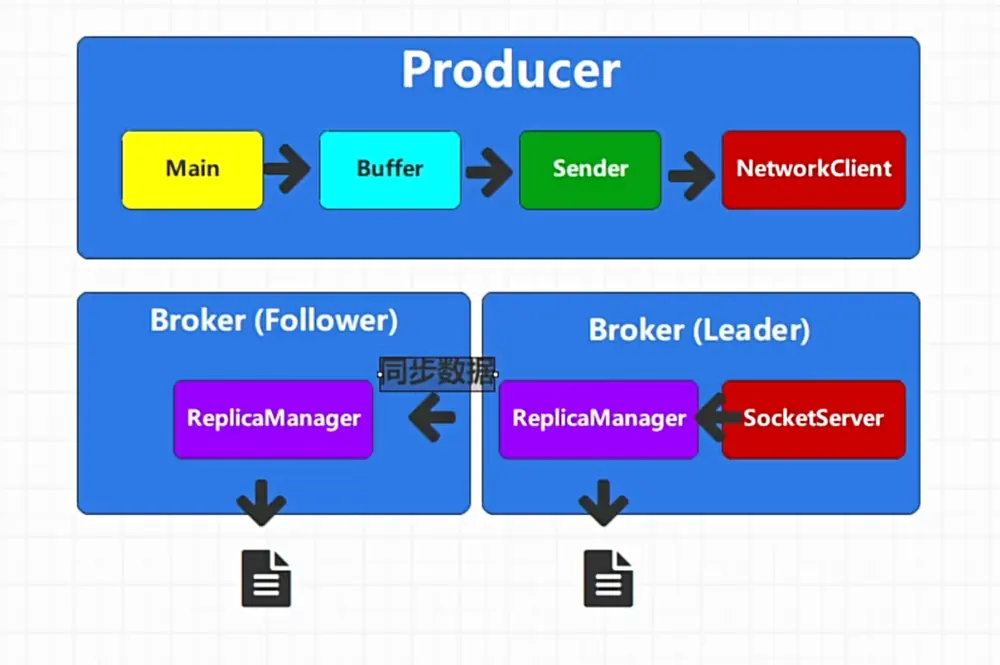
1. 生产数据流程
2. 拦截器 (Interceptor)
- 拦截器:kafka提供的一种机制,用于在消息生产者和消费者之间插入自定义的逻辑。 可以继承Interceptor接口,实现自定义的拦截器。
3. 分区器
- 分区器:kafka提供的一种机制,用于将消息分配到不同的分区中。 根据元数据(就是整个kafka集群的配置信息),将消息分配到不同的分区中。 同样可以继承Partitioner接口,实现自定义的分区器。
- 通常根据消息的key来分配分区,key为空时,会根据消息的hash值来分配分区。
- 粘性分区策略
4. 数据校验与缓冲区
- 缓冲区作用: 通过缓冲区,可以实现消息的批量发送,提高生产效率。通过将同个分区的消息批量发送,可以减少网络IO次数,提高生产效率。
- batch size: 批量大小,是指每次发送的消息数量。 默认值为16k,但是为了保证数据的完整性,会根据消息的大小来调整。
5. 发送线程
- 发送线程会将缓冲区数据进行调整,根据集群服务器的编排,将位于不同broker的消息批量发送。
- 发送线程可以设置延迟时间
6. 发送确认
- Callback: 回调函数,是指在消息发送完成后,会调用的函数。
- 可以通过设置Callback,来实现消息发送后的操作。
-
发送和响应是异步线程,我们设计的发送线程会将数据放入缓冲区,而发送线程会根据缓冲区中的数据,来发送消息。
- 也可以使用阻塞,使的消息响应完成再执行下一条消息发送。实现消息的同步发送。
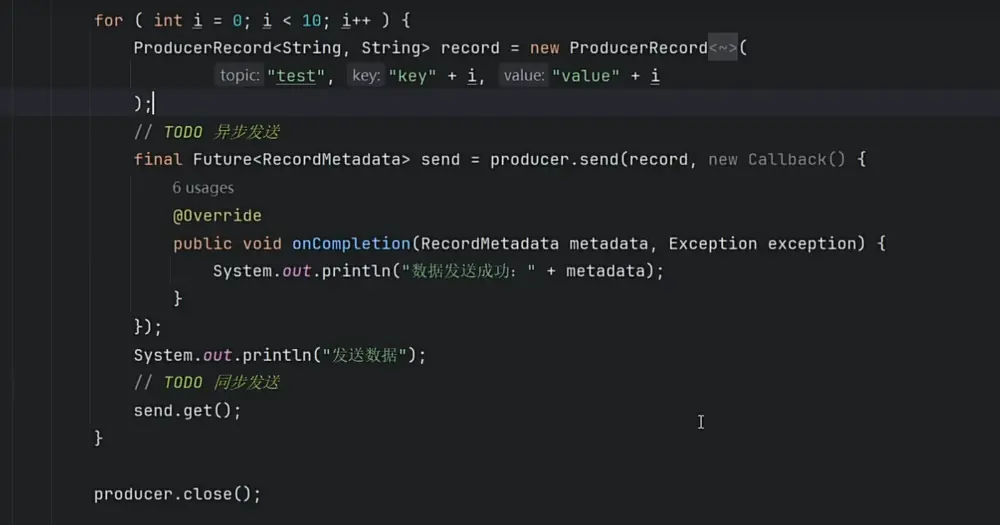
// Future 作用: 用于异步操作的回调,当异步操作完成后,会调用Future的get方法,返回异步操作的结果。 Future<RecordMetadata> future = producer.send(record); - ACKs: 确认消息发送的类型。 可以设置为0、1、2。
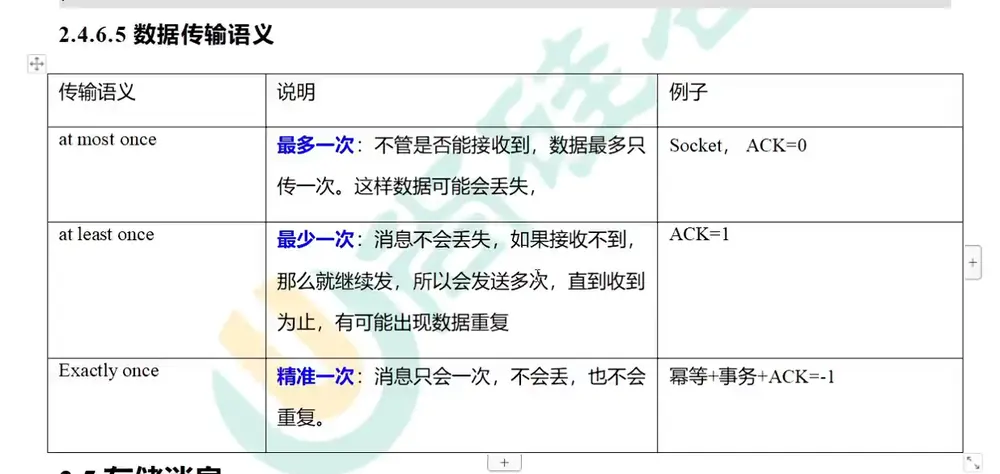
- 0: 只确认消息发送到broker,不等待副本同步完成。只考虑发送效率。
- 1: 等待leader副本同步完成。
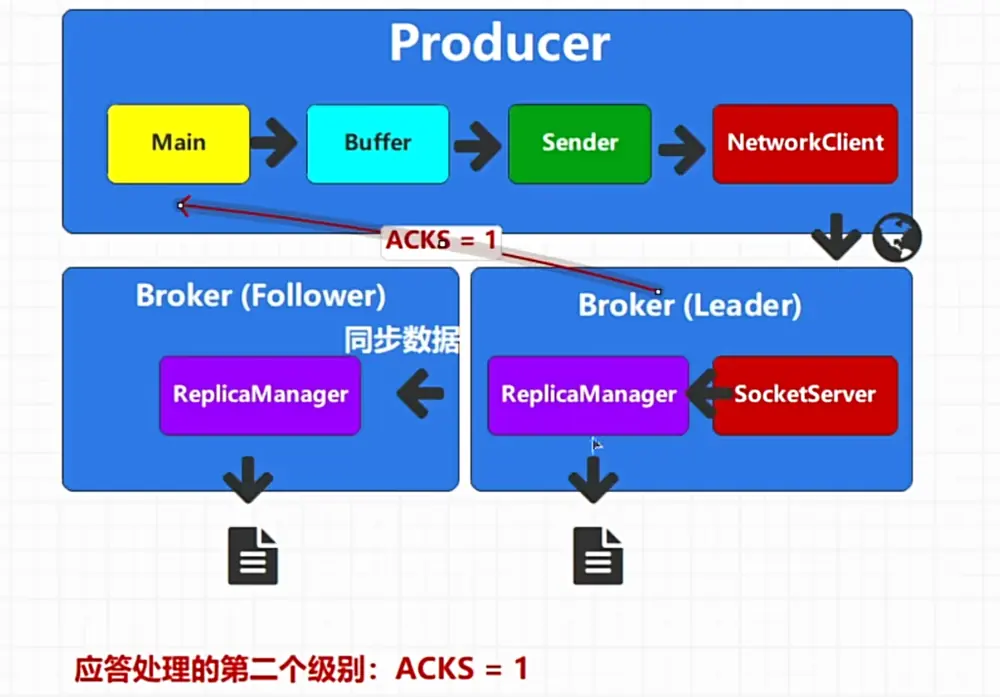
- 2:ISR副本同步完成就回调应答
- -1: 等待所有副本同步完成,包括leader和follower副本。
7. 消息重复问题和乱序问题
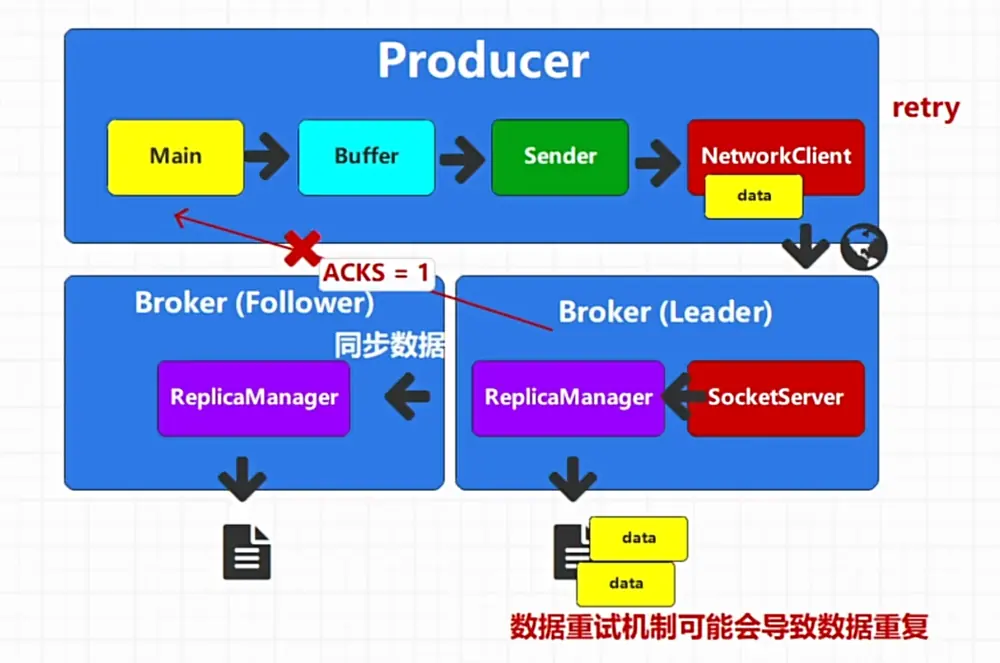
解决措施:幂等性操作,是指对一个操作进行多次,和一次操作的结果是一致的。
// 开启幂等性操作
ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG
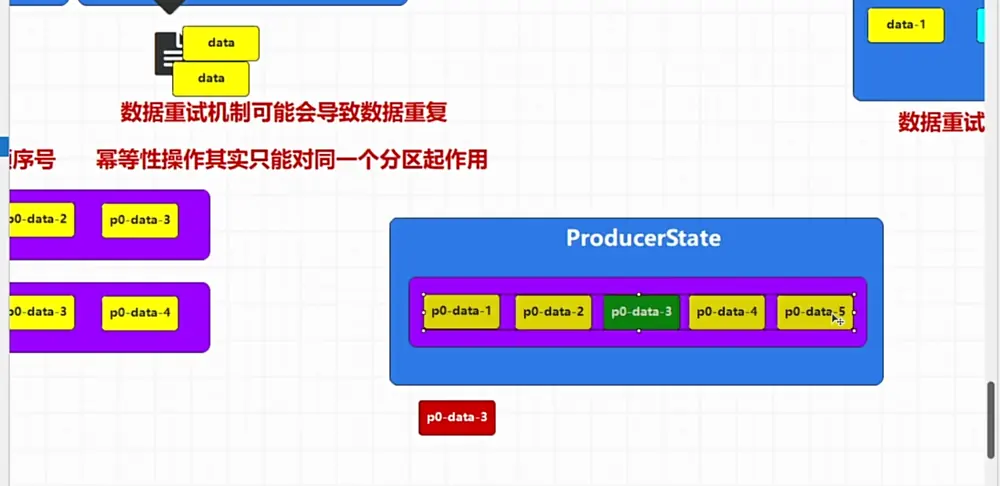
- 开启幂等性操作后,消息重复问题会得到解决。
- 幂等性要求在途请求缓冲区大小不能超过5个。
- 幂等性的原理是对消息进行唯一标识,当消息重复发送时,会根据唯一标识来判断是否重复发送。
- 幂等性因为只针对一个分区内的消息建立索引筛选,所以不能解决跨分区的消息重复问题。
-
另一方面当生产者掉线重新上线时,生产者ID会改变,所以不能解决生产者掉线重新上线时,消息重复发送的问题。
- 因此引入事务管理,解决掉线重新上线时,消息重复发送的问题。
- 事务ID与生产者绑定,保证用于判重复信息。
config.put(ProducerConfig.ENABLE_IDEMPOTENCE_CONFIG, "true");
config.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "transactional_id");
producer = new KafkaProducer<>(config);

// 初始化事务
producer.initTransactions();

try {
    // 开启事务
    producer.beginTransaction();
    producer.send(record);
    producer.commitTransaction();
} catch (ProducerFencedException | OutOfOrderSequenceException | AuthorizationException e) {
    // 处理异常
    producer.abortTransaction();
}
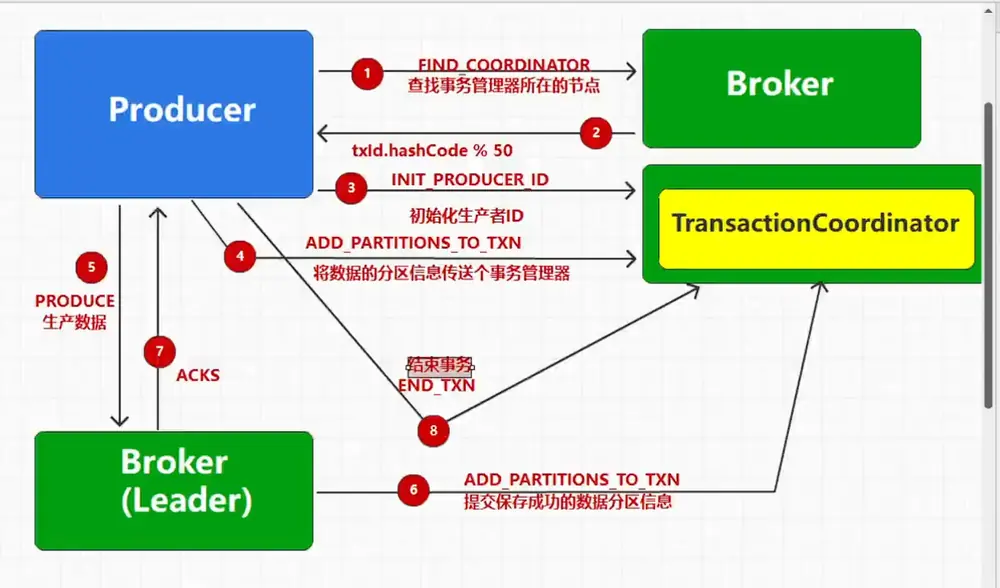
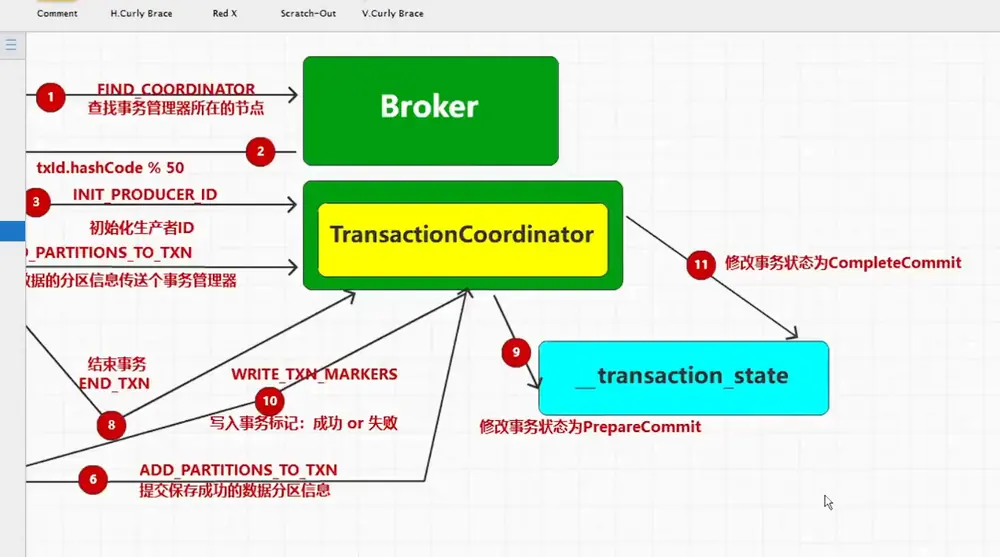
5. 数据存储
1. 数据存储机制
- 通过logmanager来管理数据的存储。定期将数据写入磁盘。
2. 数据存储流程
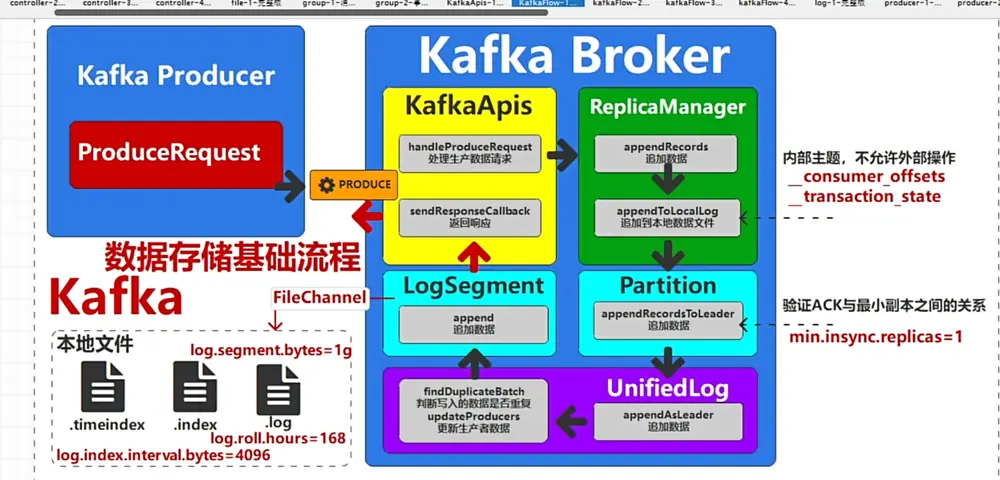
-
index文件,稀疏索引文件,用于快速定位到数据文件中的位置。
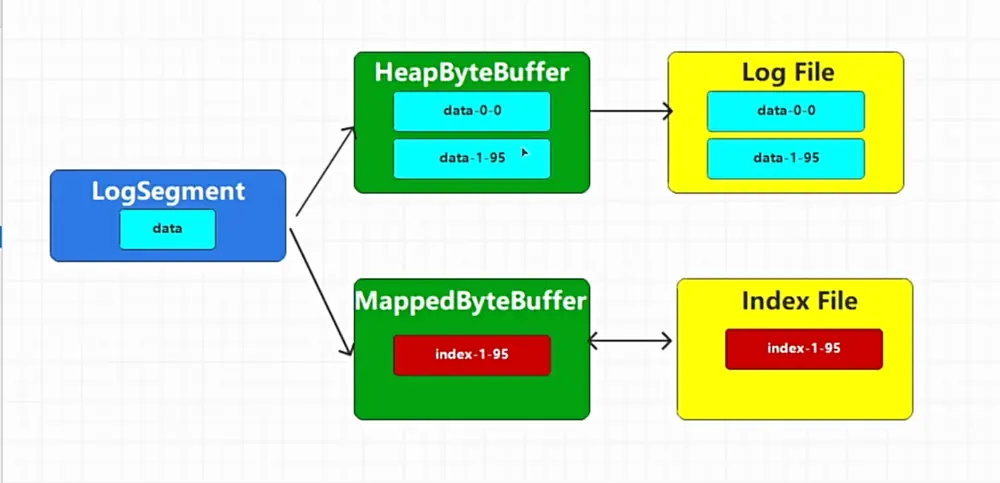
-
UnifiedLog 表: 用于存储消息的元数据,包括消息的偏移量、分区、消息ID等。通过它可以将数据文件串联起来定位数据所在位置。
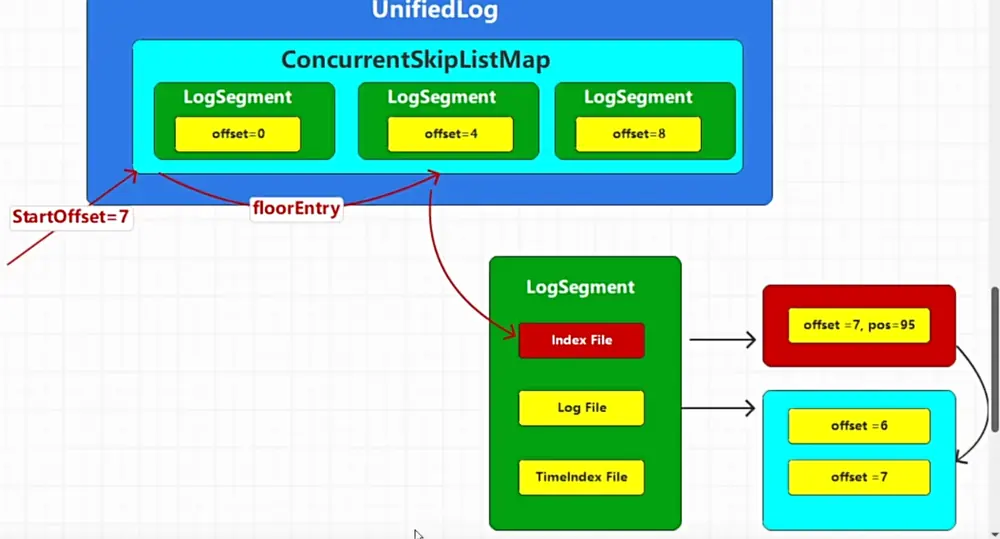
3. 数据文件格式
-
数据存储格式:批次头+数据体
- 批次头大小固定61 byte
- 数据体大小根据消息的大小来调整。
- 总体大小可根据数据压缩算法计算出来,因此得到物理偏移量。
- 数据存储与数据批次字节大小以及数据存储字节大小决定。
4. 数据同步
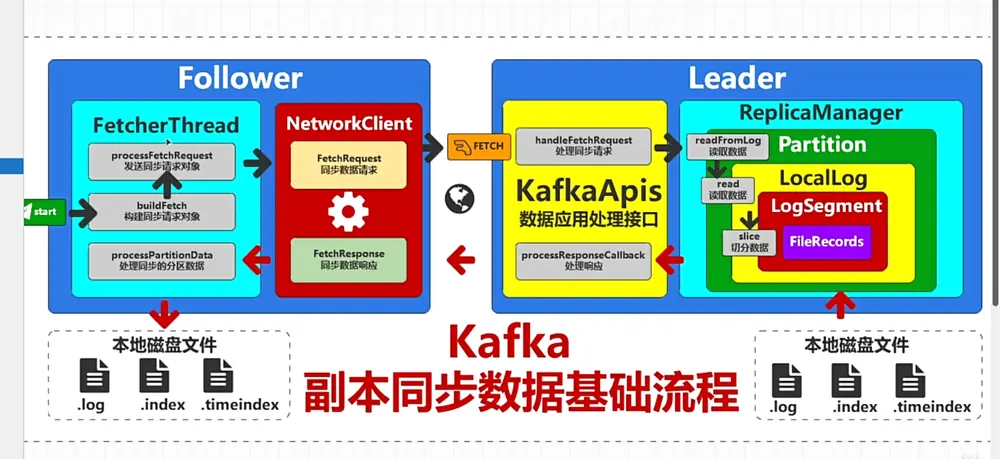
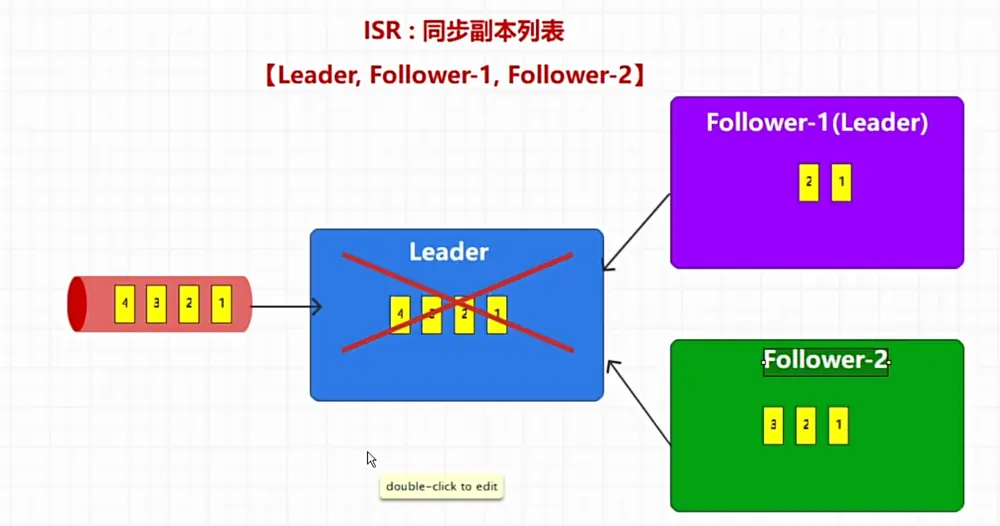
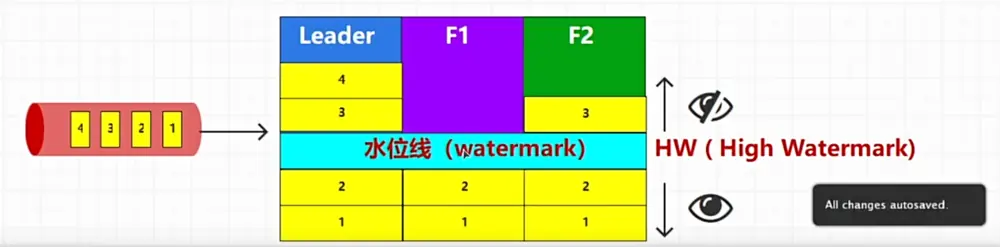
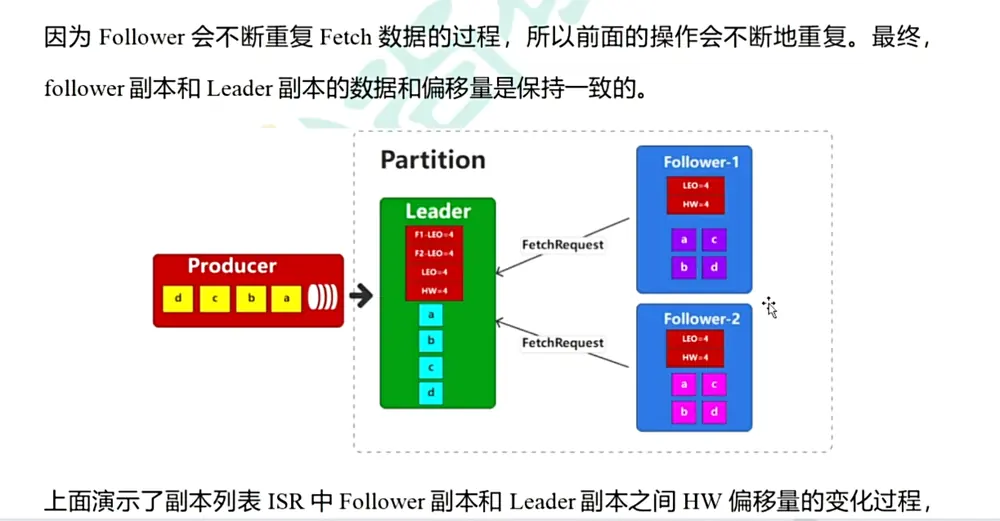
- leader设备挂掉重新上线时,会作为follower副本,从leader副本同步数据。
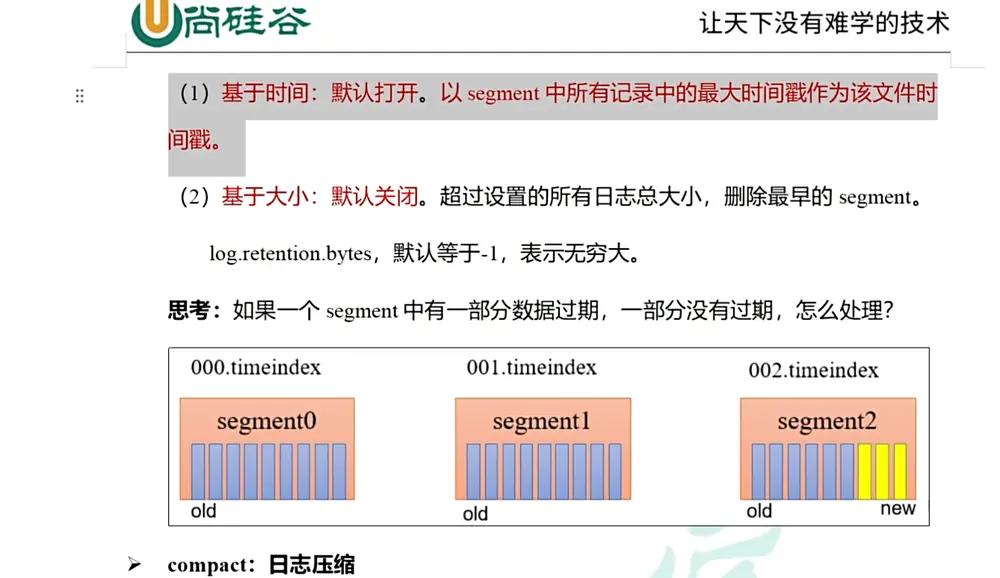
5. 数据删除
6. 消费数据
1. 消费流程
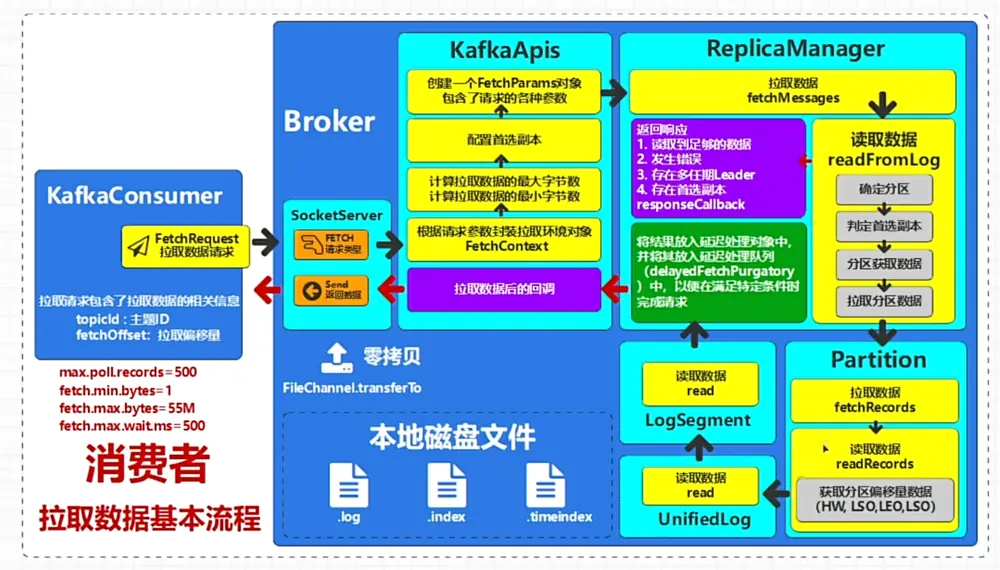
- LEO(Log End Offset): 最后一个消息的偏移量。 默认值为3.
-
消费者在消费数据时,会传递LEO值,来指定从哪个位置开始消费数据。可以通过设置ConsumerConfig.AUTO_OFFSET_RESET_CONFIG来指定从哪个位置开始消费数据。
- 消费者组: 消费者组是指多个消费者组成的一个集合。每个消费者都有一个唯一的消费者ID,消费者组的消费者之间可以并行消费数据。
-
因此组内对于消费者所消费的数据,通过kafka记录消费者消费的位置,来实现并行消费。主要通过auto.Commit.interval.ms 间隔时间去记录消费者消费的位置。
- 也可以通过设置手动保存消费者消费的位置(偏移量)。
2. 事务管理
- 消费者事务默认级别:read uncommitted
- 通过设置ConsumerConfig.ISOLATION_LEVEL_CONFIG来设置事务级别。
- 消费者从日志中读取数据时,会根据事务级别来判断是否整个生产者的事务是否完成。
3. 消费者组
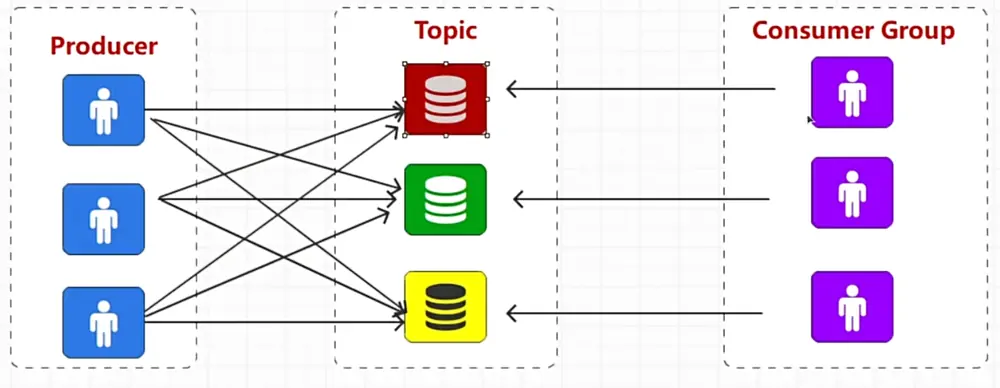
- 消费者组: 消费者组是指多个消费者组成的一个集合。每个消费者都有一个唯一的消费者ID,对于每一个分区,只能有一个消费者消费数据。
- 当消费者数量大于分区数量时,会闲置,当发生某个消费者掉线时,其会顶替掉线的消费者。
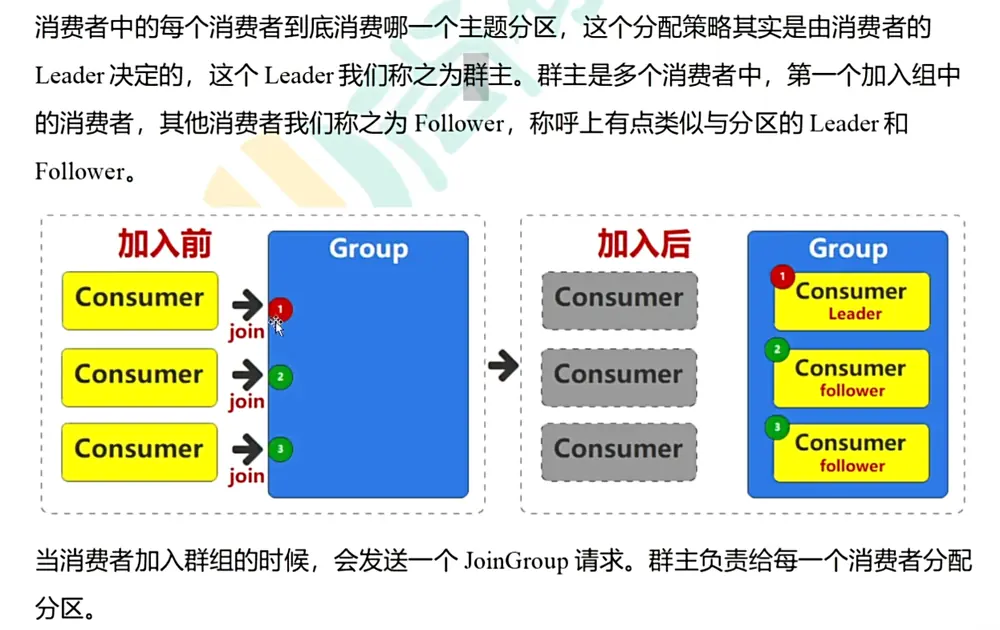
-
对于掉线的消费者,他的消费位置会通过话题“_consumer_offset”(默认有50个分区) 来记录每个分区的消费位置。方便顶替掉线的消费者从上次消费的位置继续消费。
- 分配策略:
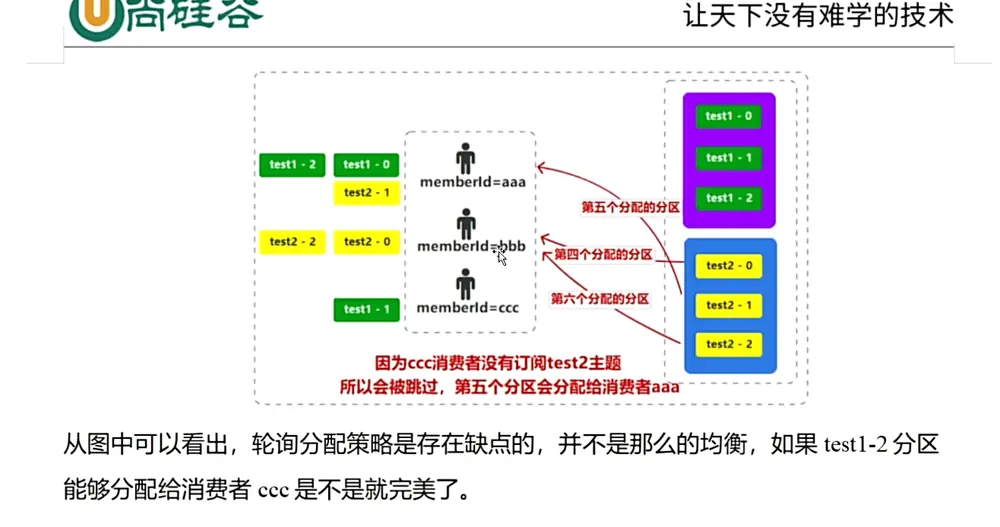
- 轮询分配: 每个消费者按顺序分配分区。UUID作为消费者ID,确保每个消费者都有一个唯一的ID。
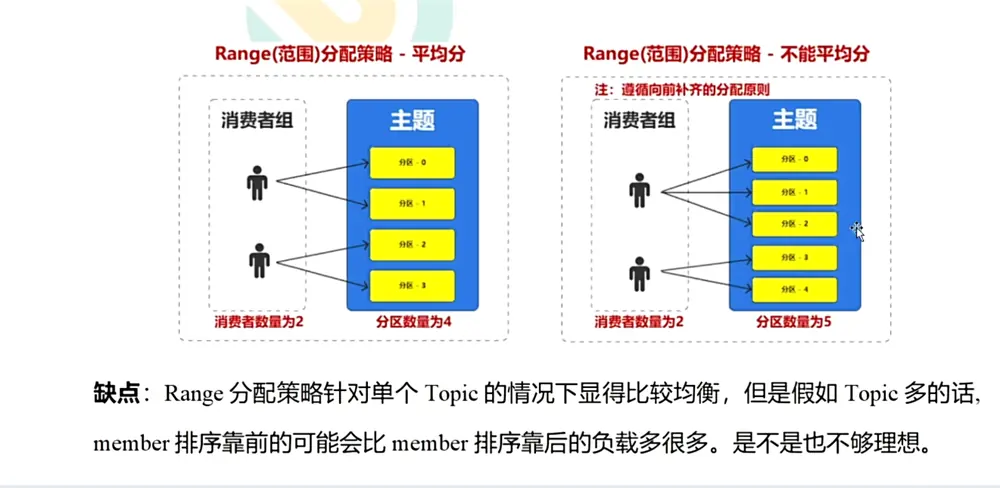
- 范围分配策略: 每个消费者按分区的数量范围分配数据。
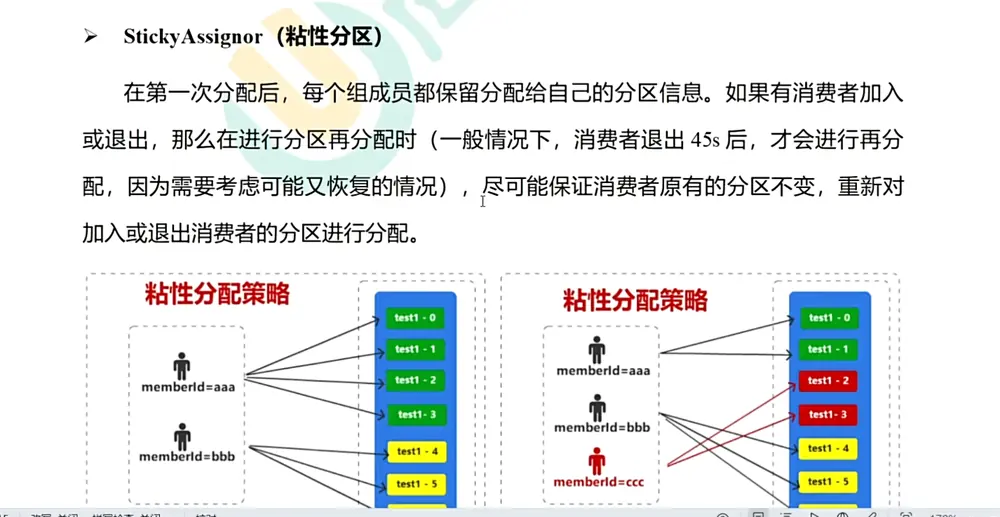
- 粘性分配:
-
ConsumerConfig.PARTITION_ASSIGNMENT_STRATEGY_CONFIG: 分配策略。
-
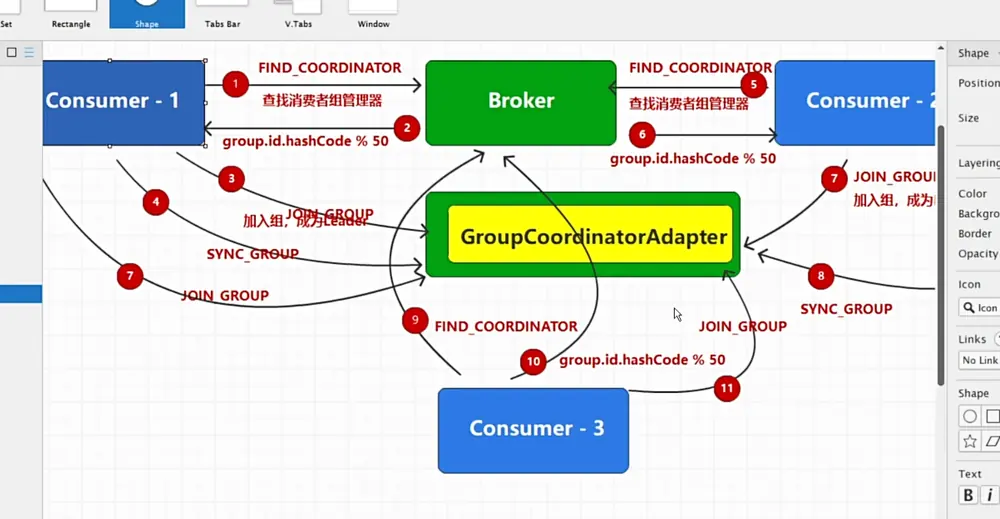
- 消费者组中消费者数量变化时,会将所有已经加入的消费者,重新分配选择leader。